ycliper

Популярное

Музыка Кино и Анимация Автомобили Животные Спорт Путешествия Игры Юмор

Интересные видео

2025 Сериалы Трейлеры Новости Как сделать Видеоуроки Diy своими руками

Топ запросов

смотреть а4 schoolboy runaway турецкий сериал смотреть мультфильмы эдисон

Видео с ютуба Agent Benchmark

Introducing APEX-Agents Benchmark

Introducing APEX-Agents Benchmark

Оценка и контрольные показатели агента — краткое содержание лекции 4 MOOC Agentic AI 2025
Оценка и контрольные показатели агента — краткое содержание лекции 4 MOOC Agentic AI 2025

Introducing Terminal-Bench: Evaluating LLM Agents in Realistic Terminal Settings | Ray Summit 2025
Introducing Terminal-Bench: Evaluating LLM Agents in Realistic Terminal Settings | Ray Summit 2025

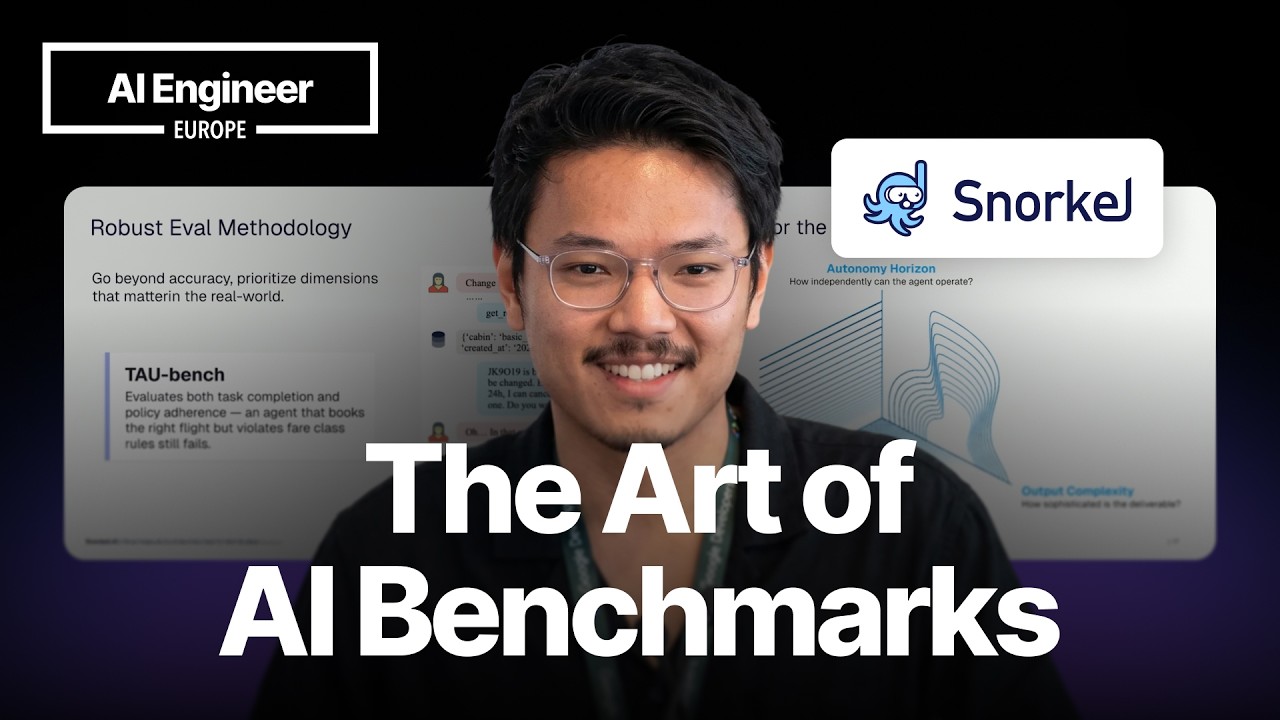
The Art & Science of Benchmarking Agents — Vincent Chen, Snorkel AI

The Art & Science of Benchmarking Agents — Vincent Chen, Snorkel AI

НОВЫЙ DeepSeek Harness — супер-агент!

НОВЫЙ DeepSeek Harness — супер-агент!

Как я на практике использовал агентов ИИ для создания эталонного теста

Как я на практике использовал агентов ИИ для создания эталонного теста

Harvey’s Legal Agent Benchmark: Explained

Harvey’s Legal Agent Benchmark: Explained

Как тестировать AI-агентов при отсутствии бенчмарков — Натаниэль Вейль, Air Canada

Как тестировать AI-агентов при отсутствии бенчмарков — Натаниэль Вейль, Air Canada

How to Benchmark AI Agents in Biology — Alfredo Andere, LatchBio

How to Benchmark AI Agents in Biology — Alfredo Andere, LatchBio

Taste-Bench: лучший ИИ-агент справляется с выбором из двух вариантов лишь на 60%

Taste-Bench: лучший ИИ-агент справляется с выбором из двух вариантов лишь на 60%

Agentic Evaluations Workshop - Deep Dive on the Future on Evals for Agents.

Agentic Evaluations Workshop - Deep Dive on the Future on Evals for Agents.

ML benchmark tasks from zero: how to test AI agents on real machine learning work

ML benchmark tasks from zero: how to test AI agents on real machine learning work

Создание оценок для агентов с возможностью оптимизации через «восхождение на холм»
Создание оценок для агентов с возможностью оптимизации через «восхождение на холм»

Не доверяйте бенчмаркам LLM — тестирование OpenAI GPT 5.2 в 🤖 Agent Zero

Не доверяйте бенчмаркам LLM — тестирование OpenAI GPT 5.2 в 🤖 Agent Zero

Бенчмарки в агентной инженерии: как я ранжирую Astra, Fable 5.1 и модели с открытыми весами

Бенчмарки в агентной инженерии: как я ранжирую Astra, Fable 5.1 и модели с открытыми весами

Локальные ИИ-агенты для программирования на Strix Halo и R9700: тесты Pi, Opencode и SWE-bench Mini

Локальные ИИ-агенты для программирования на Strix Halo и R9700: тесты Pi, Opencode и SWE-bench Mini

AI Agent Evals 101: Stop Guessing, Start Measuring

AI Agent Evals 101: Stop Guessing, Start Measuring

How to Benchmark Frontier LLM? with Florian Brand from Prime Intellect
How to Benchmark Frontier LLM? with Florian Brand from Prime Intellect

LLM & AI Agent Benchmarks vs Reality: Why AI Applications Break

LLM & AI Agent Benchmarks vs Reality: Why AI Applications Break

Оценка агентов на SWE-Bench

Оценка агентов на SWE-Bench

Следующая страница»

© 2025 ycliper. Все права защищены.


  • Контакты
  • О нас
  • Политика конфиденциальности


Контакты для правообладателей: [email protected]